
一句话做视频 · 不用素材,不用注册
说一句话,AI 当场做出一条会动的视频。
你说:
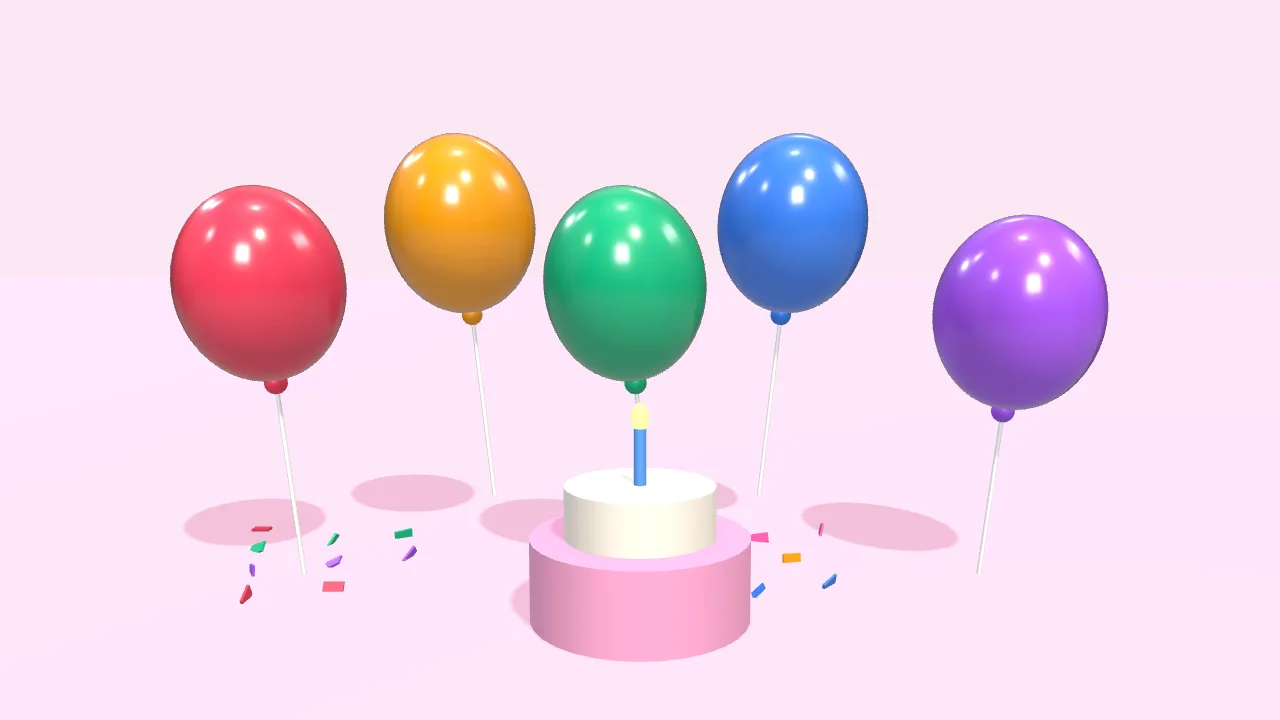
做一条 10 秒生日祝福:彩色气球飘起来,最后打出「生日快乐」
- 建一个 3D 场景
- 放 5 个气球,往上飘
- 加上蛋糕和飘落的彩纸
- 打出文字,弹入
- 导出 10 秒成片
你说:
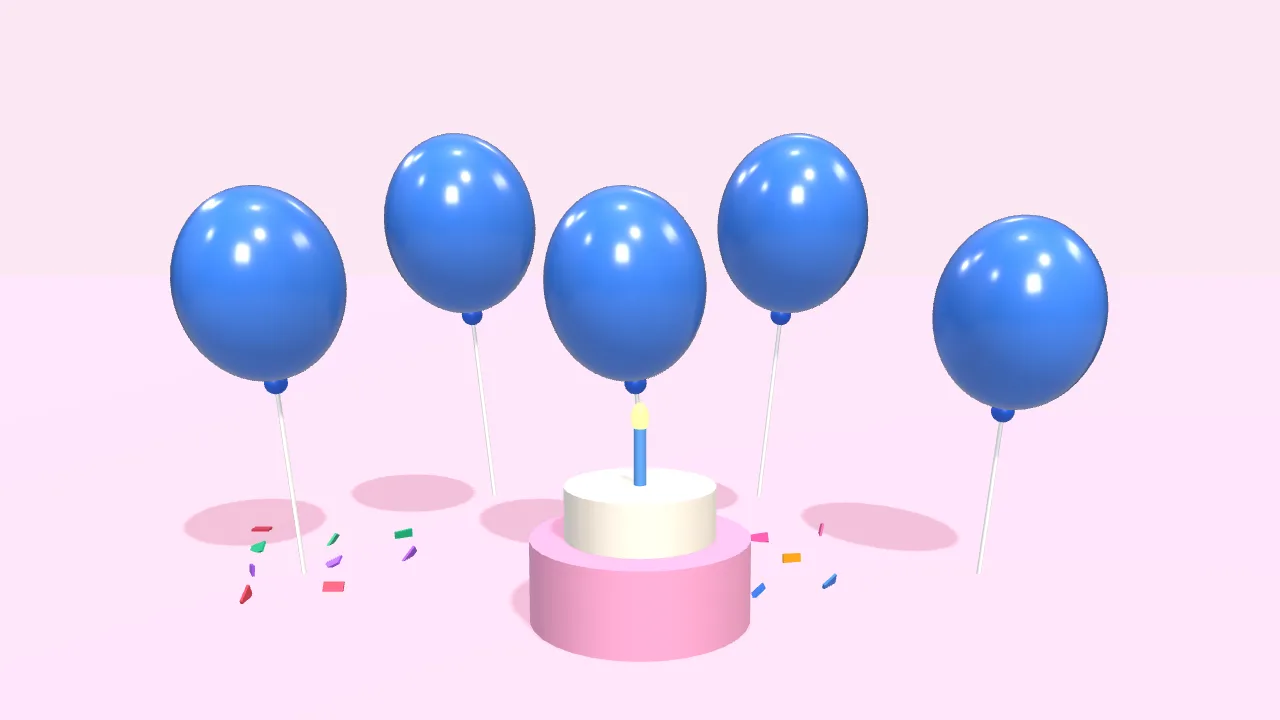
字大一点换成黄色,气球换成蓝色
- 字号放大
- 颜色 白 → 黄
- 气球换成蓝色
你说:
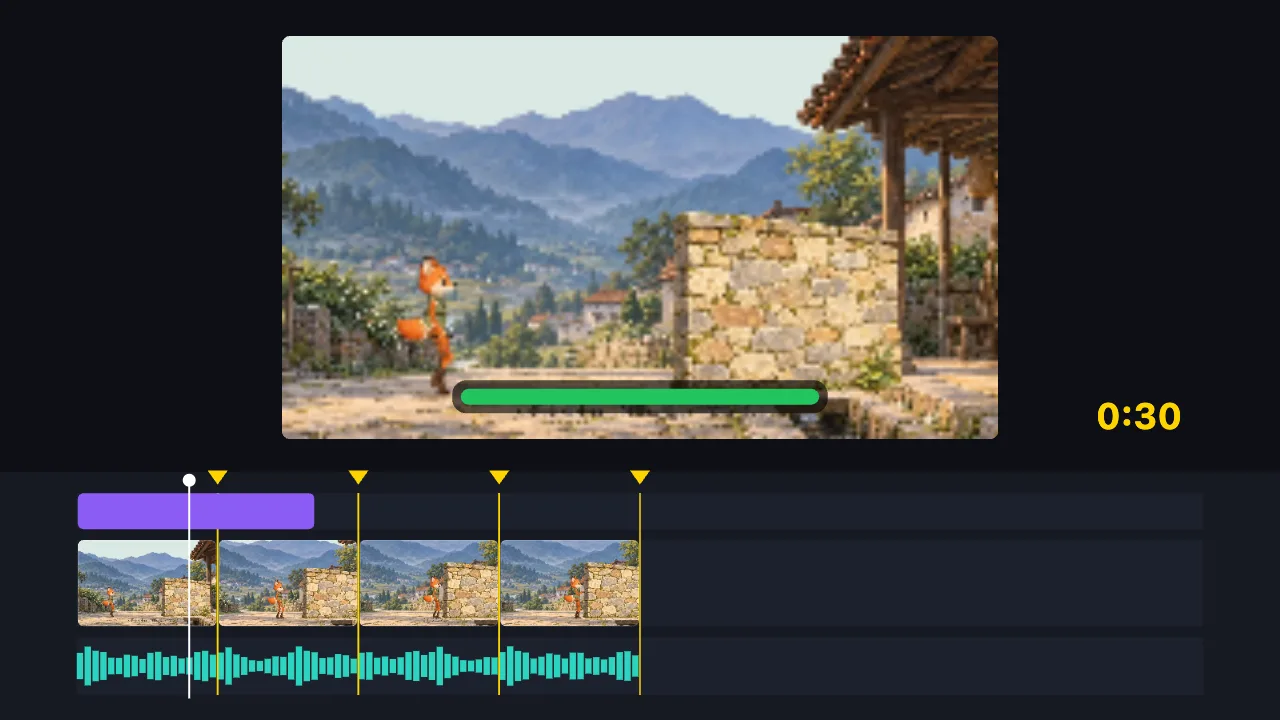
这段 2 分钟录像剪到 30 秒,按音乐鼓点切,加个标题
- 找到音乐鼓点
- 按鼓点切成 8 段,删掉空段
- 加标题
- 导出 30 秒成片
你说:
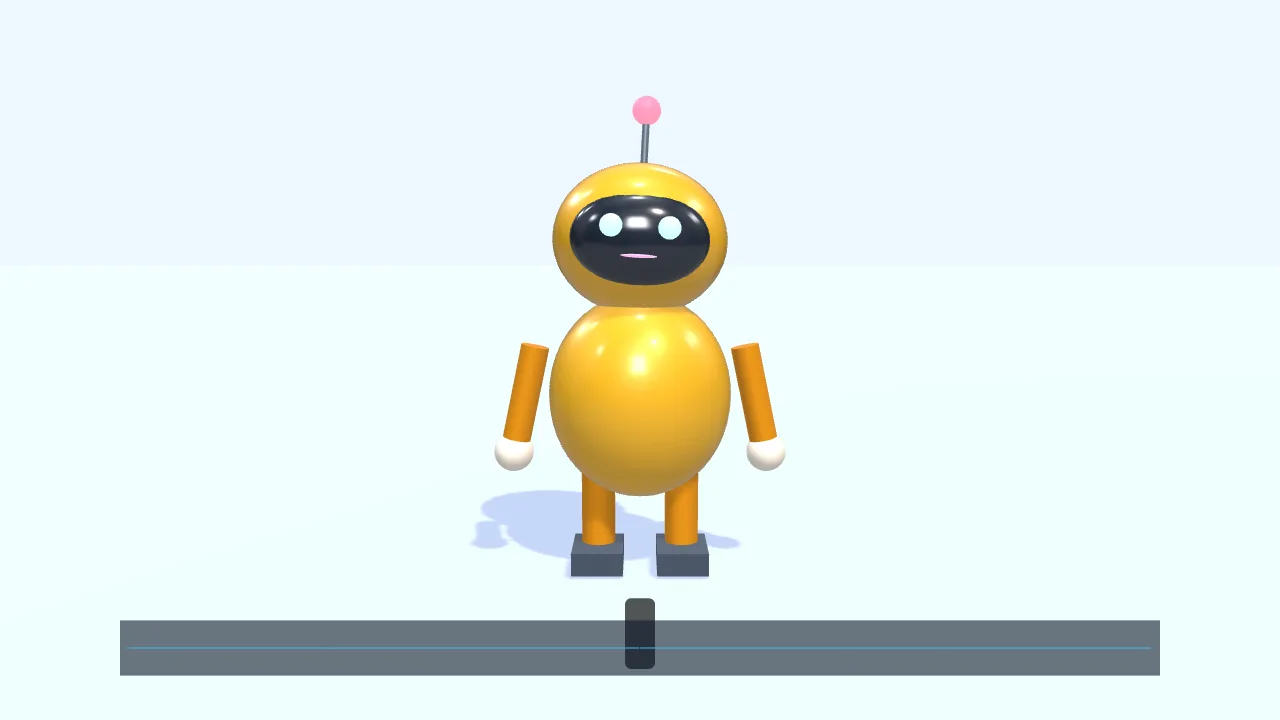
让一个角色从左边走进来,跟着这段声音说话
- 放一个 3D 小机器人
- 走到画面中间,挥挥手
- 放入一段声音
- 嘴巴跟着声音开合
- 配上字幕
你说:
做一个金色礼盒转一圈,打出「新品上市」
- 建一个 3D 场景
- 放一个礼盒
- 换成金色金属质感
- 打两盏光
- 让它转一圈
- 打出「新品上市」
你说:
给礼盒画面加一个「新品上市」的标题动效
- 加一段内置的标题动效
- 标题改成「新品上市」
- 导出 8 秒成片
没有跑视频生成模型、没有排队:AI 写的是一条时间轴,你的浏览器照着画出来。
AI 做不到:真人出镜的实拍画面 · 把糊掉的画质修清楚 · 去掉已有水印 · 凭空生成 3D 模型文件
说一句话,AI 当场做出一条会动的视频,不需要任何素材、不用排队、不用注册。图形动画、3D 场景、会走路会开口的角色和文字动画由你浏览器里的引擎直接绘制,几秒就能看到结果,导出没有水印。它不生成真人实拍画面。
把「做一条 10 秒的生日祝福,彩色气球往上飘,最后打出生日快乐」这句话打进去,几秒后你就能看到成片。
它不需要排队,因为它不是在跑视频生成模型。AI 做的事是直接写出一条时间轴:第几秒出现什么图形、角色或 3D 物体,怎么动,打什么字,用什么转场,然后由你浏览器里的引擎把它画出来。
它能用的东西:图形动画(形状、描边路径、文字,带关键帧和缓动)、3D 场景(基础形状、材质、灯光、镜头、物理,也能导入 .glb 模型)、一个会走路会开口的角色、骨骼动画、手绘逐帧,加上 6 套模板、文字动画、26 款滤镜、13 种转场和 20 种特效。这里没有现成的角色、场景或道具库。
做完的每一处你都还能自己改——它生成的就是一个普通工程,点开编辑器该怎么改怎么改。不满意也可以直接说「换一版」,不用重新描述一遍。
常见问题
- 真的不用注册吗?
- 不用。做视频、改视频、导出全都不需要账号。要登录的只有存云端,和要经过图图云盘的 AI 功能(让 AI 听音频做字幕、把生成的图片放进时间轴)。
- 生成的视频有水印吗?
- 没有。导出的是干净的 MP4,可以直接发布,不限次数。
- 能做多长的视频?
- 没有设时长限制。实践中 15–60 秒的效果最好,太长容易显得重复。
- 能做出真人出镜的视频吗?
- 不能。本站不生成实拍画面。它能做的是图形动画、3D 场景、绘制的角色和文字动画,风格接近插画、MG 动画和简单的 3D 展示,不是照片级写实。
- 生成之后我还能改吗?
- 能,每一处都能改。它生成的是一个普通工程,文字、形状、角色、动作、时长、配色全都可以手动调整,也可以继续跟 AI 说「把字改大一点」。
- 为什么别家的 AI 视频要排队等很久?
- 因为它们在跑扩散模型生成每一帧画面,那需要大量 GPU 算力,只能排队。这里是 AI 写时间轴、浏览器画画面,算力开销小到可以当场完成。代价是画面风格是绘制的而不是写实的。