
角色跟著你的聲音開口說話
錄一段或匯入一段聲音,角色的嘴就跟著開合。
你說:
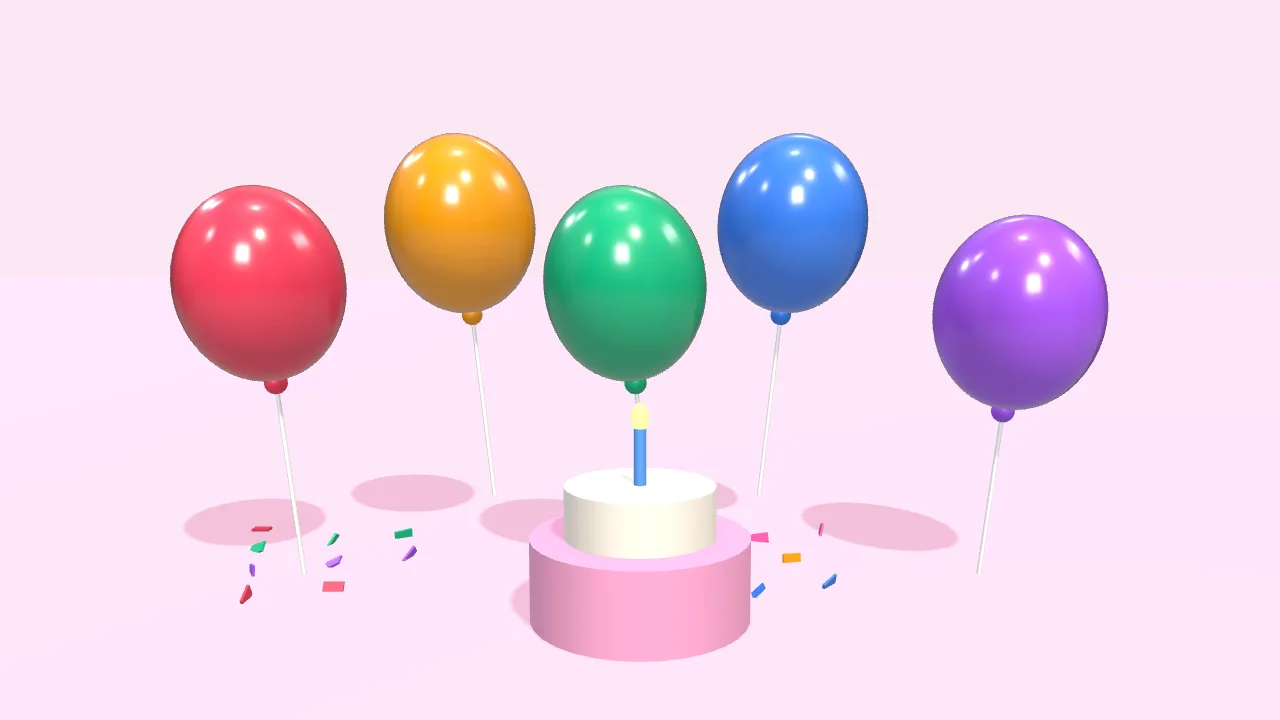
做一支 10 秒生日祝福:彩色氣球飄起來,最後打出「生日快樂!」
- 建一個 3D 場景
- 放 5 顆氣球,往上飄
- 加上蛋糕和飄落的彩紙
- 打出文字,彈入
- 匯出 10 秒成片
你說:
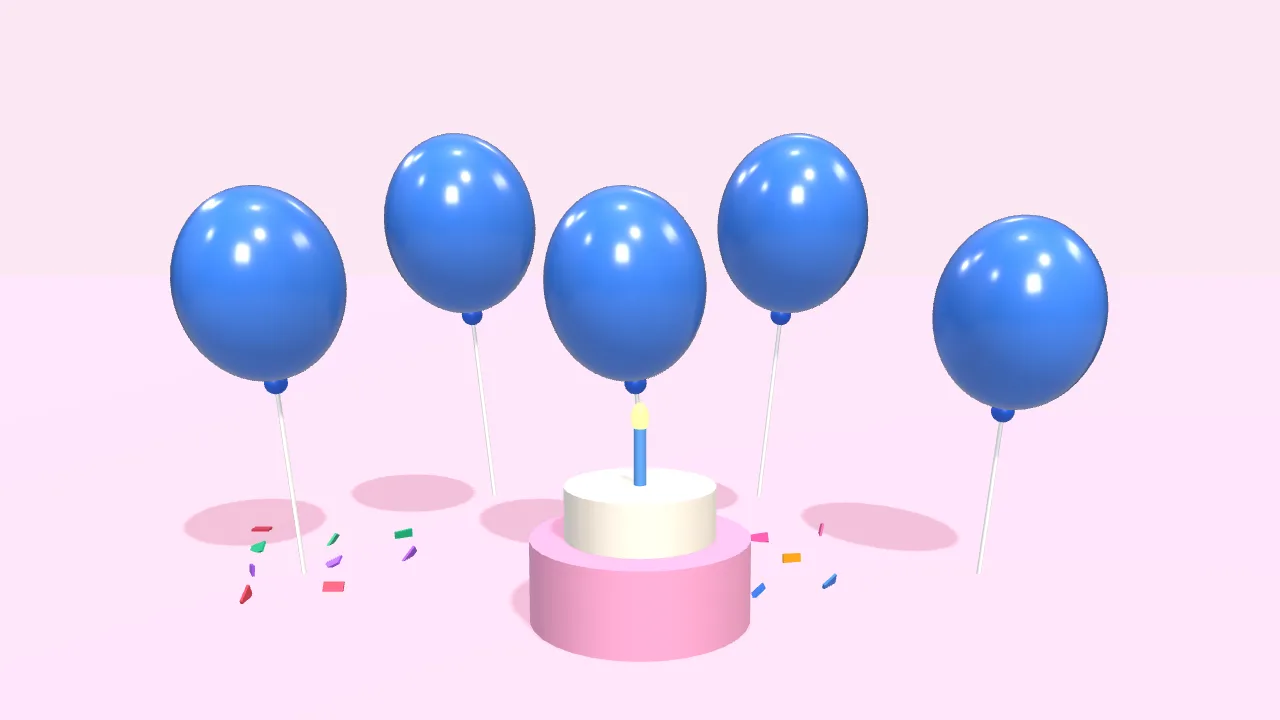
字大一點換成黃色,氣球換成藍色
- 字級放大
- 顏色 白 → 黃
- 氣球換成藍色
你說:
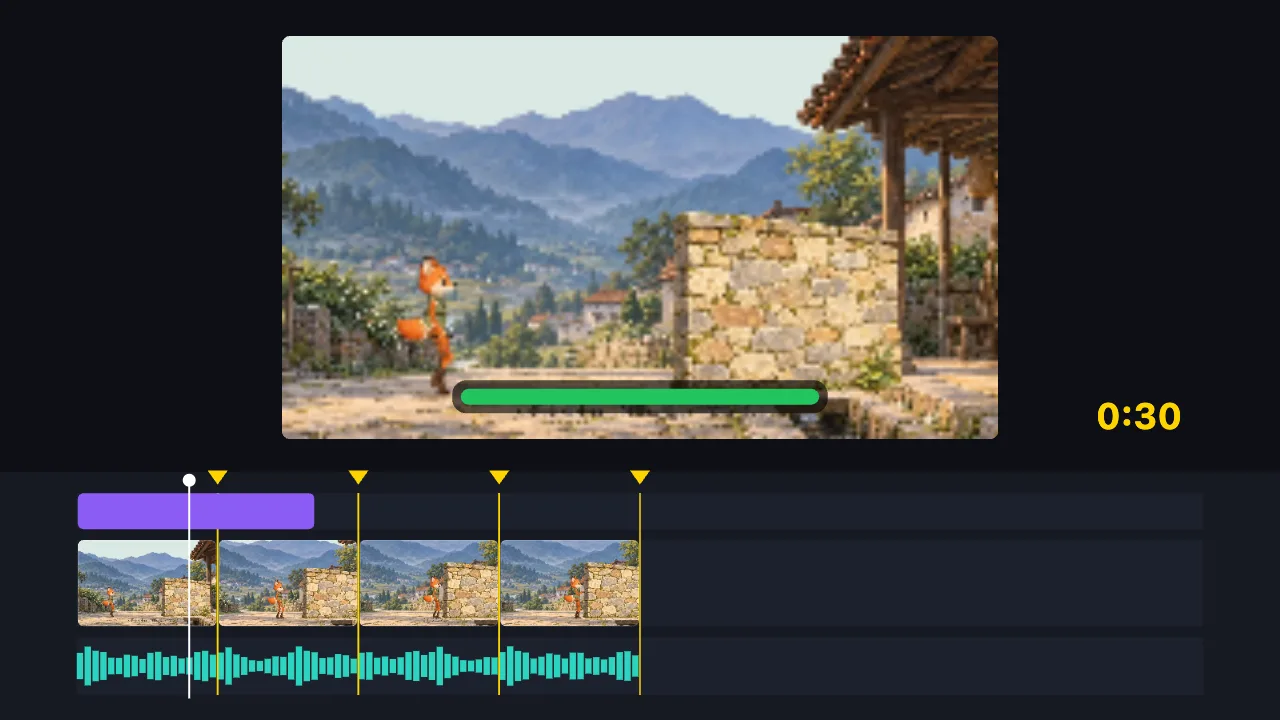
這段 2 分鐘錄影剪到 30 秒,按音樂鼓點切,加個標題
- 找到音樂鼓點
- 按鼓點切成 8 段,刪掉空段
- 加標題
- 匯出 30 秒成片
你說:
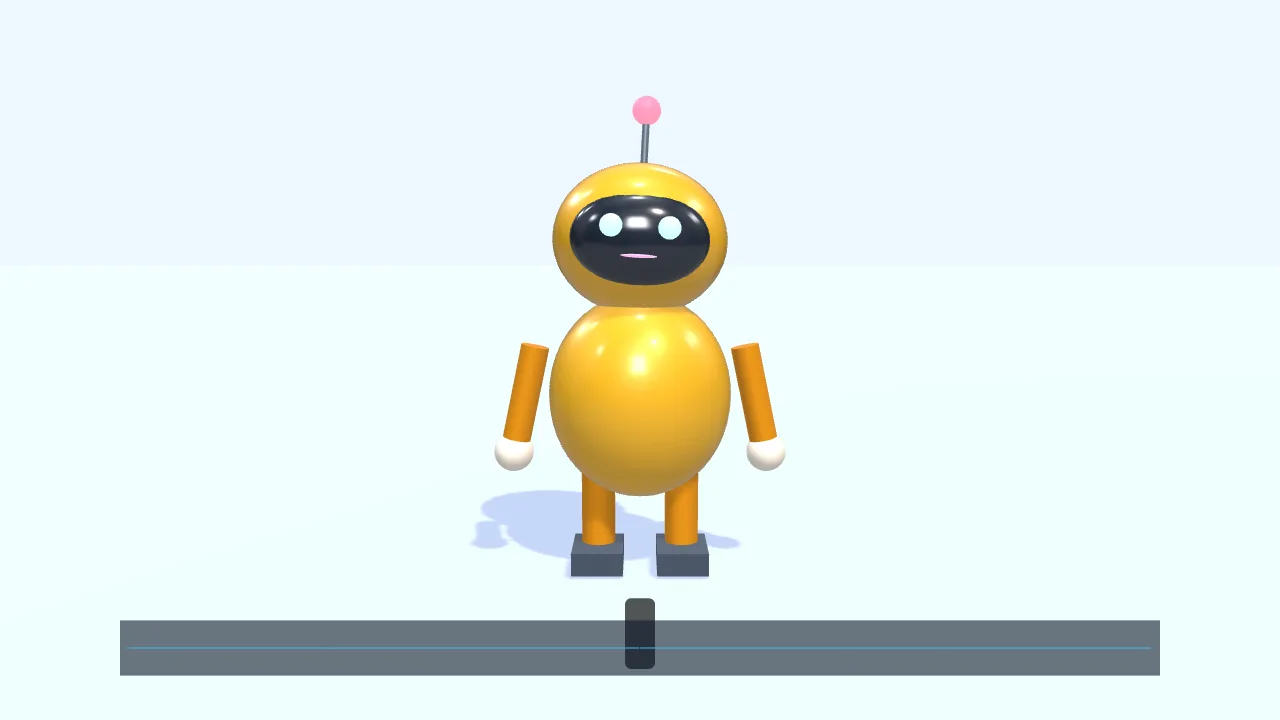
讓一個角色從左邊走進來,跟著這段聲音說話
- 放一個 3D 小機器人
- 走到畫面中間,揮揮手
- 放入一段聲音
- 嘴巴跟著聲音開合
- 配上字幕
你說:
做一個金色禮盒轉一圈,打出「新品上市」
- 建一個 3D 場景
- 放一個禮盒
- 換成金色金屬質感
- 打兩盞燈
- 讓它轉一圈
- 打出「新品上市」
你說:
幫禮盒畫面加一個「新品上市」的標題動效
- 加一段內建的標題動效
- 標題改成「新品上市」
- 匯出 8 秒成片
沒有跑影片生成模型、沒有排隊:AI 寫的是一條時間軸,你的瀏覽器照著畫出來。
AI 做不到:真人出鏡的實拍畫面 · 把糊掉的畫質修清楚 · 去掉已有浮水印 · 憑空生成 3D 模型檔案
放進一段聲音——自己錄或匯入音訊——角色的嘴就跟著這段聲音開合,免費、不用登入。嘴型按聲音的大小和節奏在幾種嘴形之間切換,在你的瀏覽器裡計算,音訊不會因此上傳。它跟的是聲音,不是逐字對準每個音。
一個角色只是站著,和它開口說話,看起來差別很大。說「讓一個角色從左邊走進來,跟著這段聲音說話」,AI 就放好角色、讓它走到畫面中間、接上聲音,再配上字幕。
做法是先有聲音:用錄音自己錄一段,或者匯入現成的音訊,再把它交給角色。嘴會跟著聲音的大小和節奏開合,在幾種嘴形之間切換,聲音停下嘴就合上。對嘴型這一步在你的瀏覽器裡計算,音訊不會因此上傳。
幾個角色可以各自跟著自己的那條聲音說話,不會串在一起。要說清楚的是:它跟的是聲音的起伏,不是按文字逐字對準每個音,近看不會像專業嘴型動畫那樣每個音都對得上;它也只讓畫出來的角色開口,不會讓真人照片或影片裡的人「說話」。
常見問題
- 嘴型會逐字對準嗎?
- 不會。它跟的是聲音的大小和節奏,在幾種嘴形之間切換。遠看自然,近看不會每個音都對得上。
- 聲音從哪來?
- 自己錄一段,或者匯入已有的音訊檔。編輯器本身不帶文字轉語音。
- 能做多人對話嗎?
- 能。每個角色跟著自己的那條聲音開口,互不干擾;輪流說就是一段對話。
- 能讓真人照片或影片裡的人開口說話嗎?
- 不能。它只讓畫出來的角色開口,不處理真人的臉。
- 要登入嗎?音訊會上傳嗎?
- 不用登入。對嘴型在你的瀏覽器裡計算,音訊不會因此上傳。