
角色跟着你的声音开口说话
录一段或导入一段声音,角色的嘴就跟着开合。
你说:
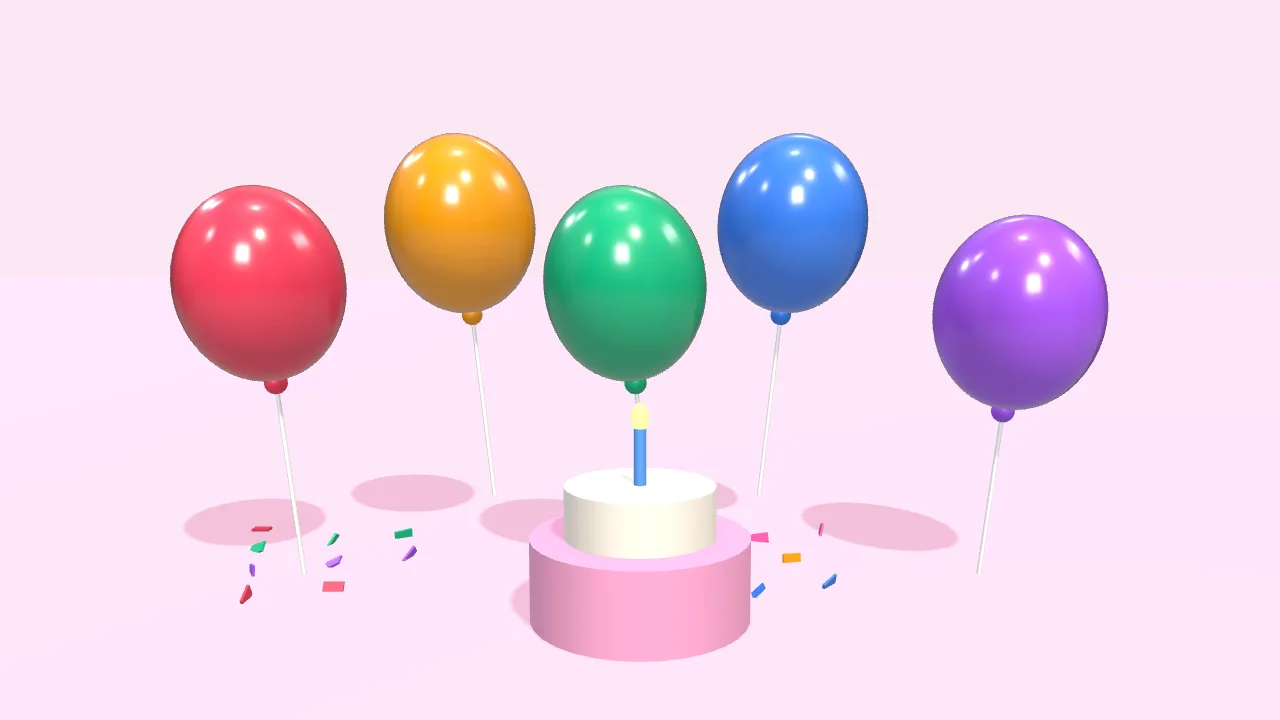
做一条 10 秒生日祝福:彩色气球飘起来,最后打出「生日快乐」
- 建一个 3D 场景
- 放 5 个气球,往上飘
- 加上蛋糕和飘落的彩纸
- 打出文字,弹入
- 导出 10 秒成片
你说:
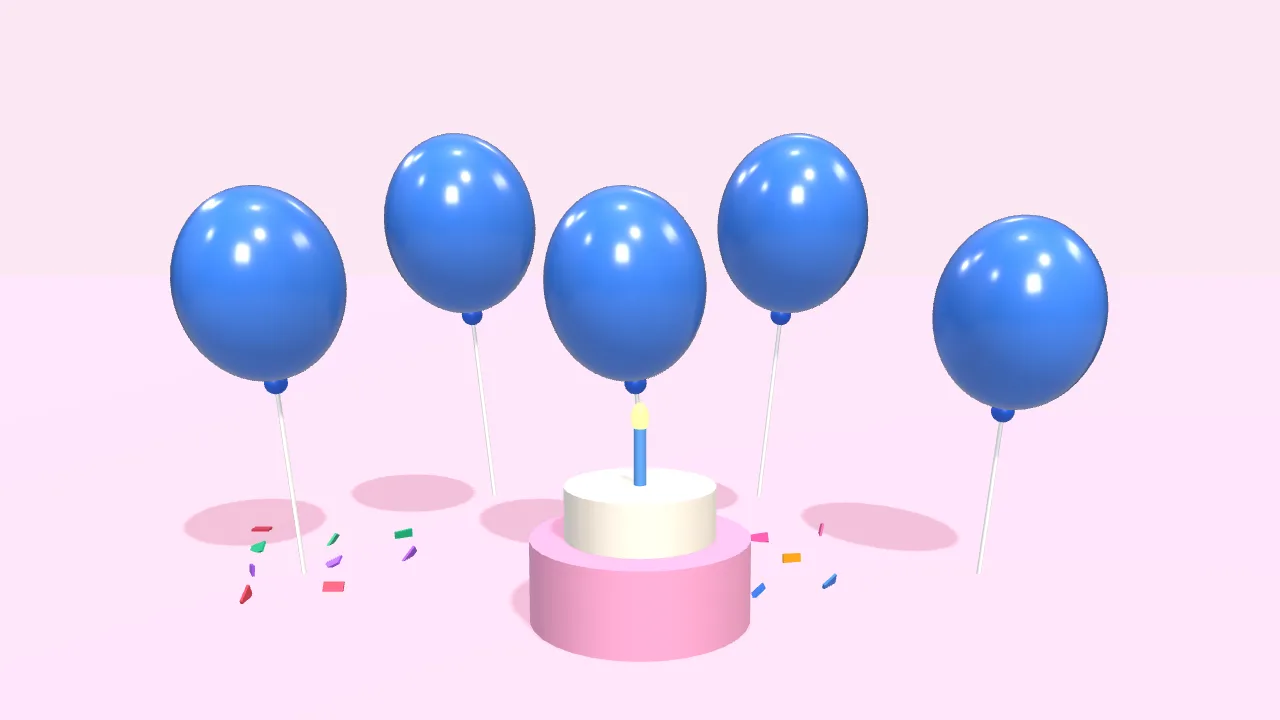
字大一点换成黄色,气球换成蓝色
- 字号放大
- 颜色 白 → 黄
- 气球换成蓝色
你说:
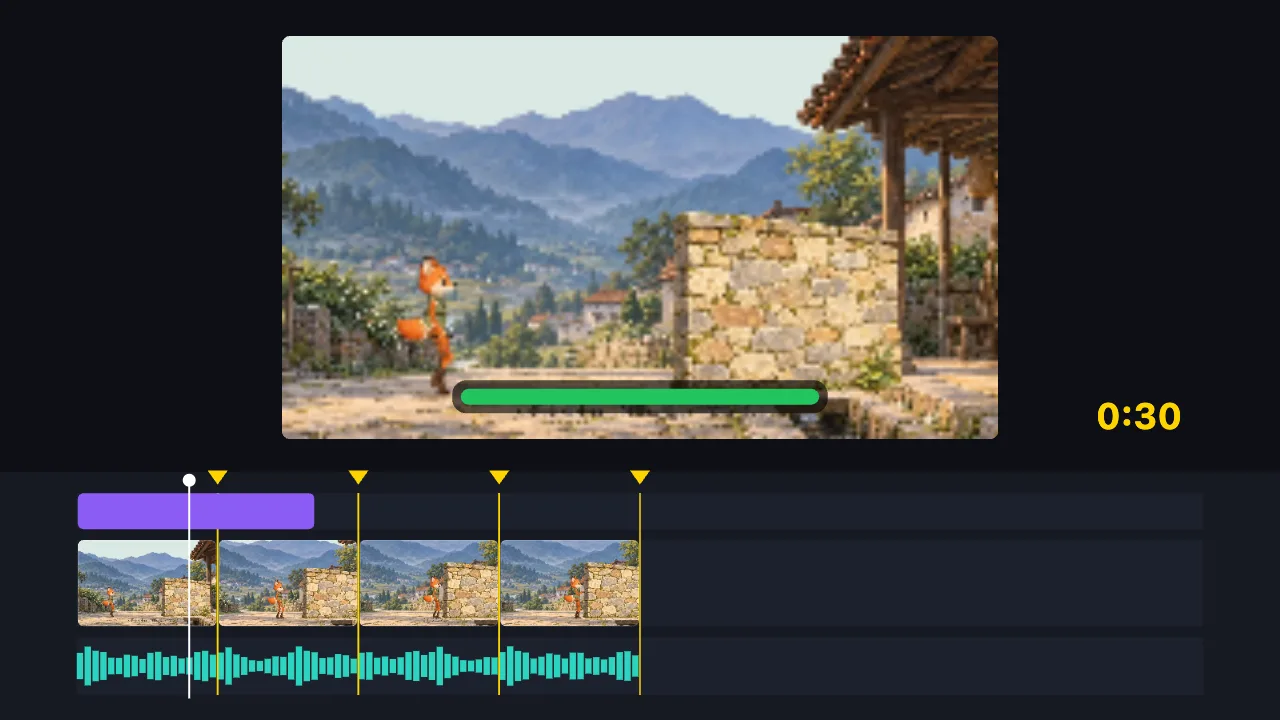
这段 2 分钟录像剪到 30 秒,按音乐鼓点切,加个标题
- 找到音乐鼓点
- 按鼓点切成 8 段,删掉空段
- 加标题
- 导出 30 秒成片
你说:
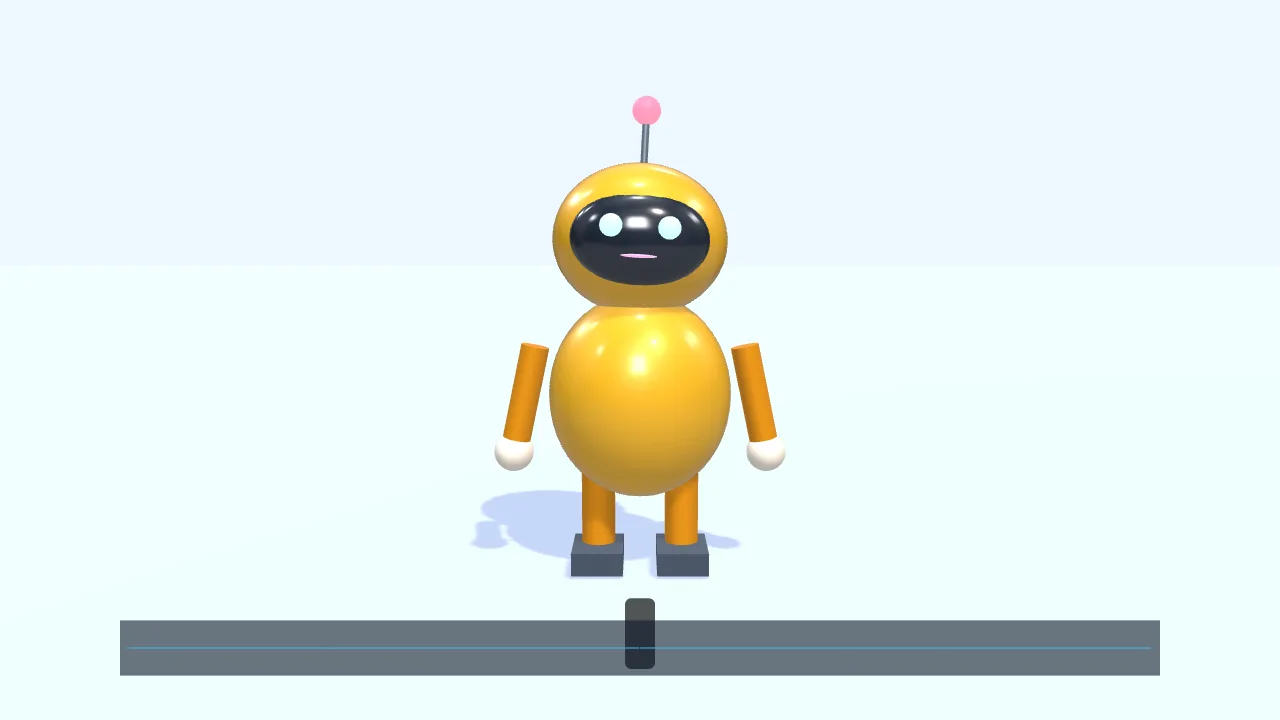
让一个角色从左边走进来,跟着这段声音说话
- 放一个 3D 小机器人
- 走到画面中间,挥挥手
- 放入一段声音
- 嘴巴跟着声音开合
- 配上字幕
你说:
做一个金色礼盒转一圈,打出「新品上市」
- 建一个 3D 场景
- 放一个礼盒
- 换成金色金属质感
- 打两盏光
- 让它转一圈
- 打出「新品上市」
你说:
给礼盒画面加一个「新品上市」的标题动效
- 加一段内置的标题动效
- 标题改成「新品上市」
- 导出 8 秒成片
没有跑视频生成模型、没有排队:AI 写的是一条时间轴,你的浏览器照着画出来。
AI 做不到:真人出镜的实拍画面 · 把糊掉的画质修清楚 · 去掉已有水印 · 凭空生成 3D 模型文件
放进一段声音——自己录或导入音频——角色的嘴就跟着这段声音开合,免费、不用登录。口型按声音的大小和节奏在几种嘴形之间切换,在你的浏览器里算,音频不会因此上传。它跟的是声音,不是逐字对准每个音。
一个角色只是站着,和它开口说话,看起来差别很大。说「让一个角色从左边走进来,跟着这段声音说话」,AI 就放好角色、让它走到画面中间、接上声音,再配上字幕。
做法是先有声音:用录音自己录一段,或者导入现成的音频,再把它交给角色。嘴会跟着声音的大小和节奏开合,在几种嘴形之间切换,声音停下嘴就合上。对口型这一步在你的浏览器里算,音频不会因此上传。
几个角色可以各自跟着自己的那条声音说话,不会串。要说清楚的是:它跟的是声音的起伏,不是按文字逐字对准每个音,近看不会像专业口型动画那样每个音都对得上;它也只让画出来的角色开口,不会让真人照片或视频里的人「说话」。
常见问题
- 口型会逐字对准吗?
- 不会。它跟的是声音的大小和节奏,在几种嘴形之间切换。远看自然,近看不会每个音都对得上。
- 声音从哪来?
- 自己录一段,或者导入已有的音频文件。编辑器本身不带文字转语音。
- 能做多人对话吗?
- 能。每个角色跟着自己的那条声音开口,互不串;轮流说就是一段对话。
- 能让真人照片或视频里的人开口说话吗?
- 不能。它只让画出来的角色开口,不处理真人的脸。
- 要登录吗?音频会上传吗?
- 不用登录。对口型在你的浏览器里算,音频不会因此上传。