
一言で動画を作る · 素材も登録も不要
一言話せば、AI がその場で動く動画を作ります。
よくある頼み方 10 秒の誕生日メッセージ、カラフルな風船が上へ飛んでいく感じで最初の 10 秒を削って、タイトルを入れてこの動画に字幕を付けて
あなた:
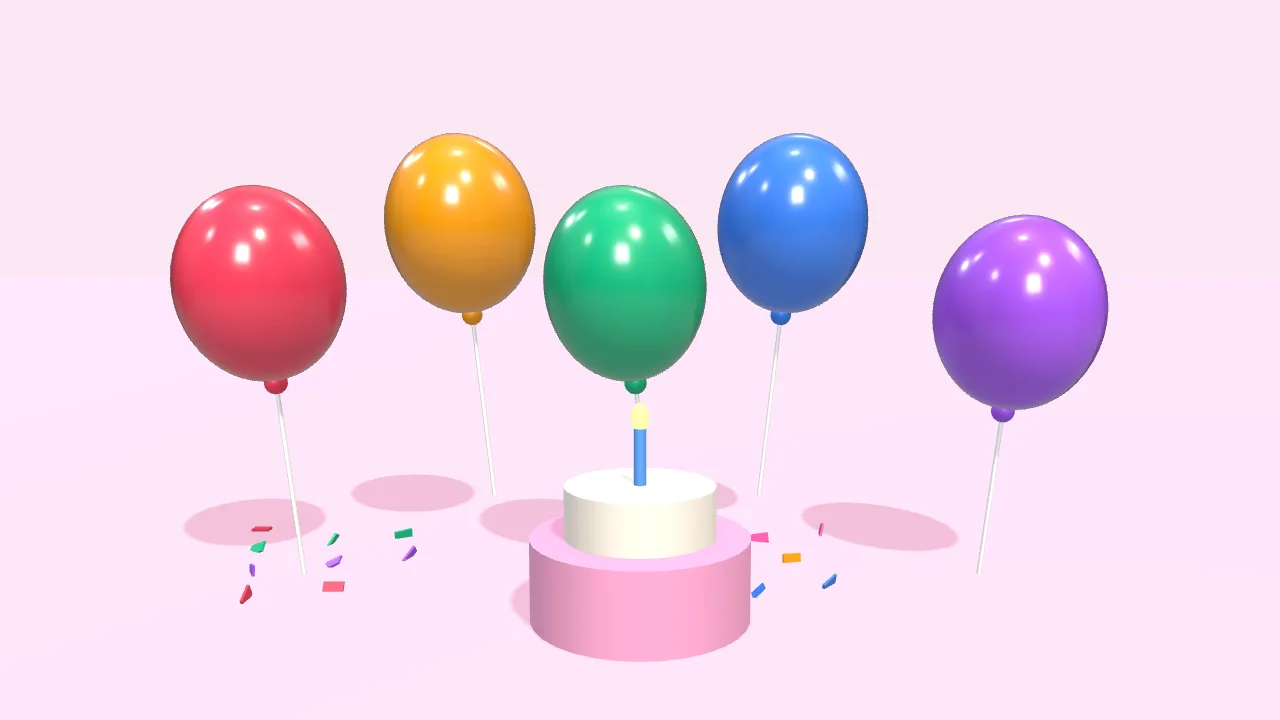
10 秒の誕生日メッセージを:カラフルな風船がふわっと上がって、最後に「お誕生日おめでとう!」
- 3D シーンを作る
- 風船を 5 個、上へ飛ばす
- ケーキと舞い落ちる紙吹雪を追加
- 文字をポップイン
- 10 秒の動画を書き出し
あなた:
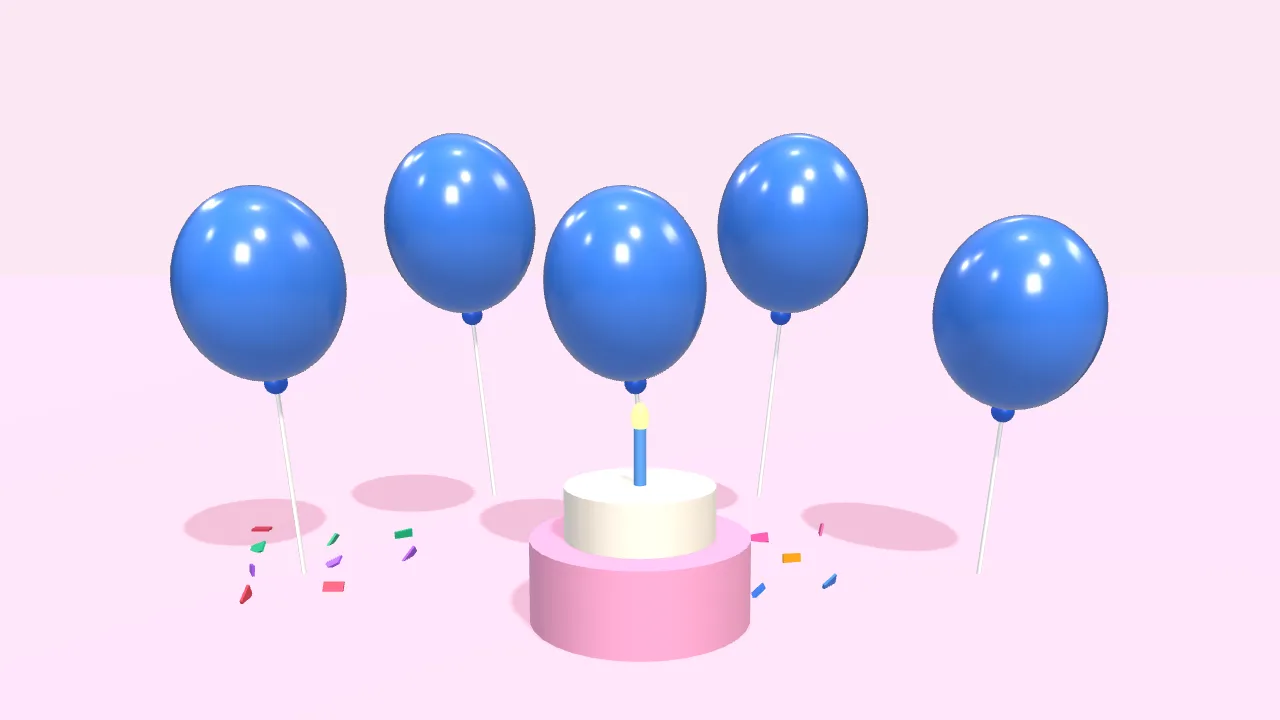
文字を大きく黄色に、風船は青に
- 文字サイズを拡大
- 色 白 → 黄
- 風船 → 青
あなた:
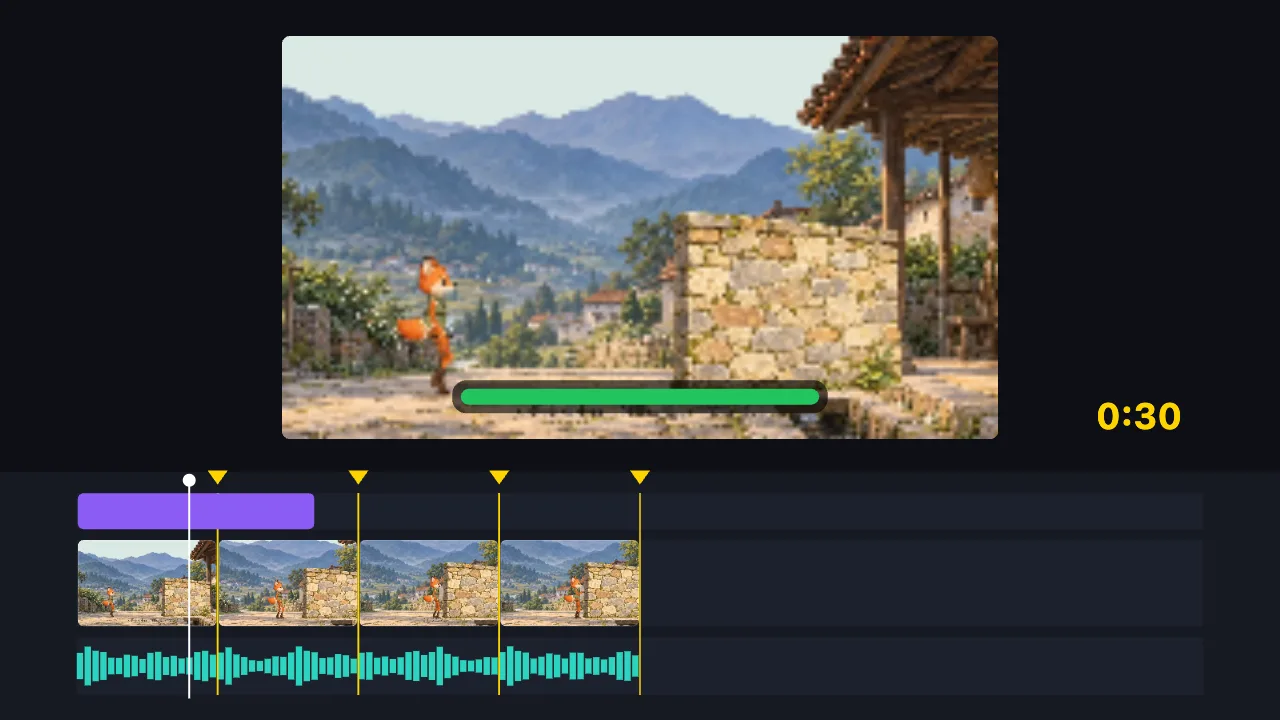
この 2 分の動画を曲のビートで 30 秒に、タイトルも付けて
- 曲のビートを検出
- ビートで 8 分割し、不要部分を削除
- タイトルを追加
- 30 秒の動画を書き出し
あなた:
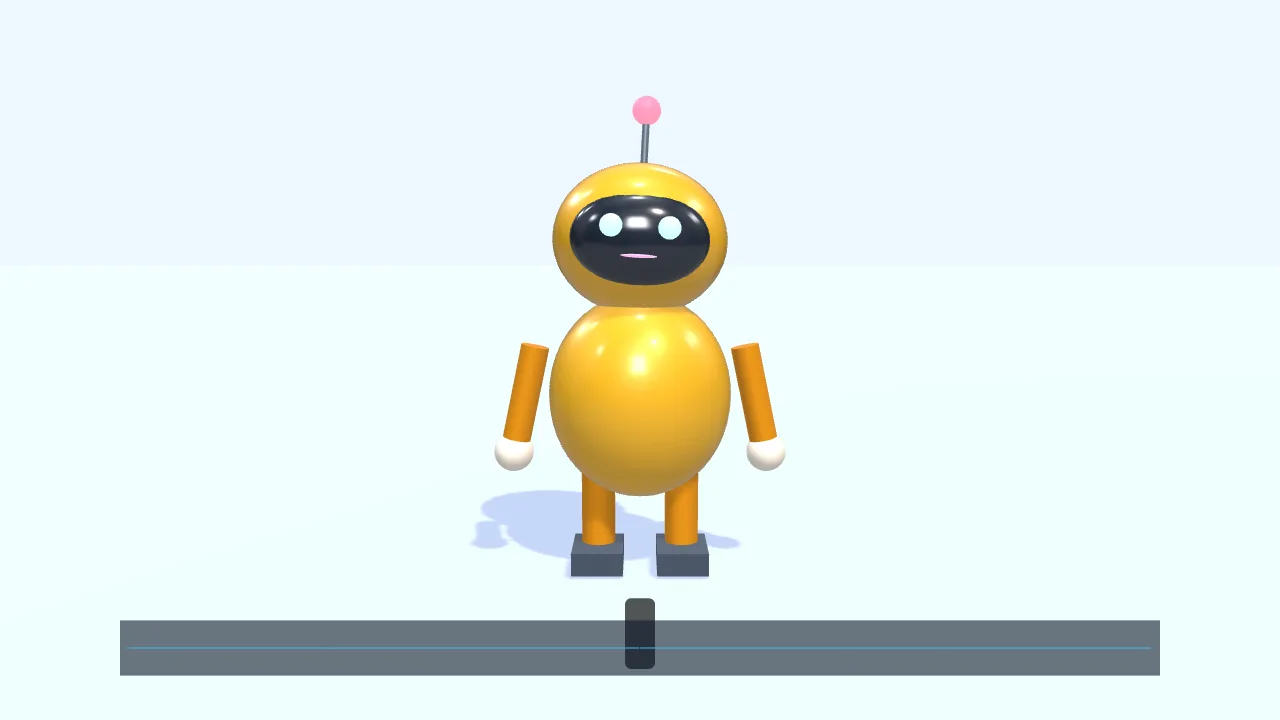
キャラクターを左から歩いて登場させて、この音声に合わせてしゃべらせて
- 3D の小さなロボットを置く
- 画面の中央まで歩いて手を振る
- 音声を入れる
- 声に合わせて口が開閉
- 字幕を付ける
あなた:
金色のギフトボックスを一回転させて、「新発売」と出して
- 3D シーンを作成
- ギフトボックスを置く
- 金色のメタル質感に
- ライトを 2 灯
- 一回転させる
- 「新発売」を表示
あなた:
ギフトボックスの映像に「新発売」のタイトルアニメーションを付けて
- 内蔵のタイトル演出を追加
- タイトルを「新発売」に変更
- 8 秒の動画を書き出し
動画生成モデルも待ち時間もありません。AI がタイムラインを書き、ブラウザがそれを描きます。
AI にできないこと:実写の人物映像の生成 · ぼやけた画質の修復 · 既存の透かしの除去 · 3D モデルファイルをゼロから生成
一言話せば、AI がその場で動く動画を作ります。素材も順番待ちも登録も不要です。モーショングラフィックス、3D シーン、歩いて話すキャラクター、文字アニメーションはブラウザ内のエンジンが直接描くので、数秒で結果が見られ、書き出しに透かしは入りません。実写の人物映像は生成しません。
「10 秒の誕生日メッセージ、カラフルな風船が上へ飛んで、最後に『お誕生日おめでとう』と出して」と入力すれば、数秒後には完成した動画が見られます。
順番待ちがないのは、動画生成モデルを回していないからです。AI がするのはタイムラインを書くこと:何秒にどの図形・キャラクター・3D オブジェクトが出て、どう動き、どんな文字を出し、どのトランジションでつなぐか。それをブラウザ内のエンジンが描きます。
使えるもの:モーショングラフィックス(図形、描き出されるパス、文字。キーフレームとイージング付き)、3D シーン(基本図形、マテリアル、ライト、カメラ、物理。.glb モデルの読み込みも可)、歩いて話すキャラクター、ボーンアニメーション、手描きのコマ送りアニメ、さらにテンプレート 6 種、文字アニメーション、フィルター 26 種、トランジション 13 種、エフェクト 20 種。既製のキャラクター・シーン・小道具のライブラリはありません。
出来上がったものは、どこでも自分で直せます。生成されるのはふつうのプロジェクトなので、エディターを開いて好きなように変更できます。気に入らなければ「別のバージョンにして」と言うだけで、最初から説明し直す必要はありません。
よくある質問
- 本当に登録しなくていいのですか?
- 不要です。動画の作成・修正・書き出しにアカウントは要りません。ログインが必要なのはクラウド保存と、TutuDriveを経由する AI 機能(AI に音声を聞かせて字幕を作る、生成した画像をタイムラインに置く)だけです。
- 生成した動画に透かしは入りますか?
- 入りません。書き出されるのはきれいな MP4 で、そのまま公開でき、回数制限もありません。
- どのくらいの長さの動画を作れますか?
- 長さの制限は設けていません。実際には 15〜60 秒がいちばん効果的で、長すぎると単調に感じられがちです。
- 実在の人物が出る動画は作れますか?
- 作れません。このサイトは実写映像を生成しません。作れるのはモーショングラフィックス、3D シーン、描かれたキャラクター、文字アニメーションで、雰囲気はイラストやモーショングラフィックス、シンプルな 3D の商品紹介に近く、写真のようなリアルさではありません。
- 生成したあとで直せますか?
- はい、どこでも直せます。生成されるのはふつうのプロジェクトで、文字、図形、キャラクター、動き、長さ、配色をすべて手で調整できますし、「文字をもう少し大きく」と AI に続けて頼むこともできます。
- ほかの AI 動画サービスはなぜ長く待たされるのですか?
- 拡散モデルで 1 コマずつ映像を生成しているからです。大量の GPU 計算が必要なので、順番待ちになります。ここでは AI がタイムラインを書き、ブラウザが映像を描くので、計算の負担が小さく、その場で終わります。その代わり、見た目は写実的ではなく、描かれたものになります。