
あなたの声に合わせて、キャラクターがしゃべる
声を録音するか読み込めば、キャラクターの口がそれに合わせて開閉します。
よくある頼み方 10 秒の誕生日メッセージ、カラフルな風船が上へ飛んでいく感じで最初の 10 秒を削って、タイトルを入れてこの動画に字幕を付けて
あなた:
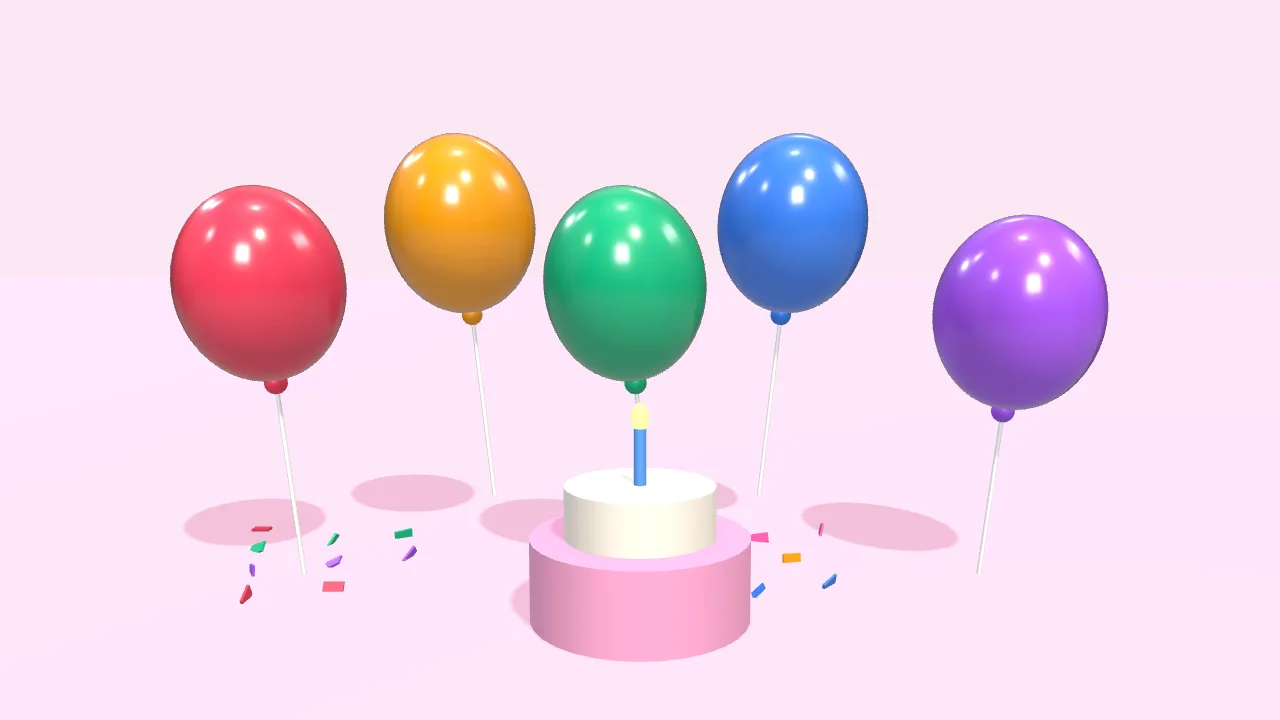
10 秒の誕生日メッセージを:カラフルな風船がふわっと上がって、最後に「お誕生日おめでとう!」
- 3D シーンを作る
- 風船を 5 個、上へ飛ばす
- ケーキと舞い落ちる紙吹雪を追加
- 文字をポップイン
- 10 秒の動画を書き出し
あなた:
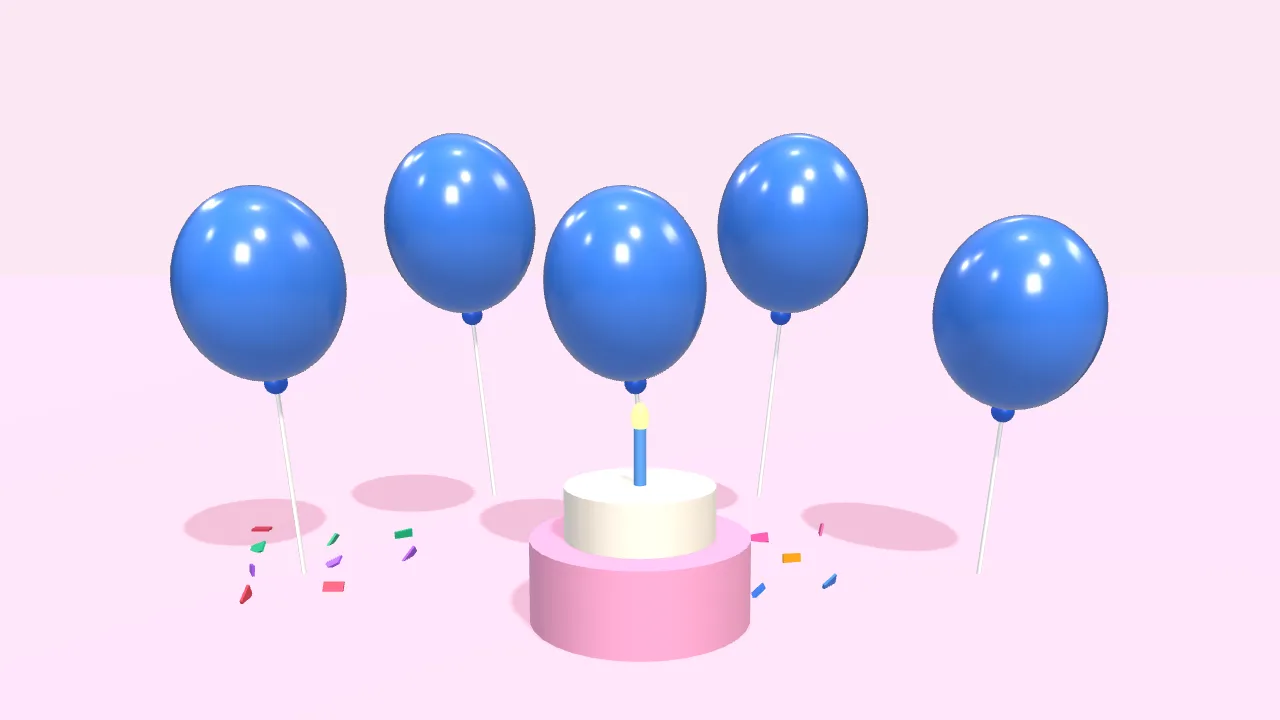
文字を大きく黄色に、風船は青に
- 文字サイズを拡大
- 色 白 → 黄
- 風船 → 青
あなた:
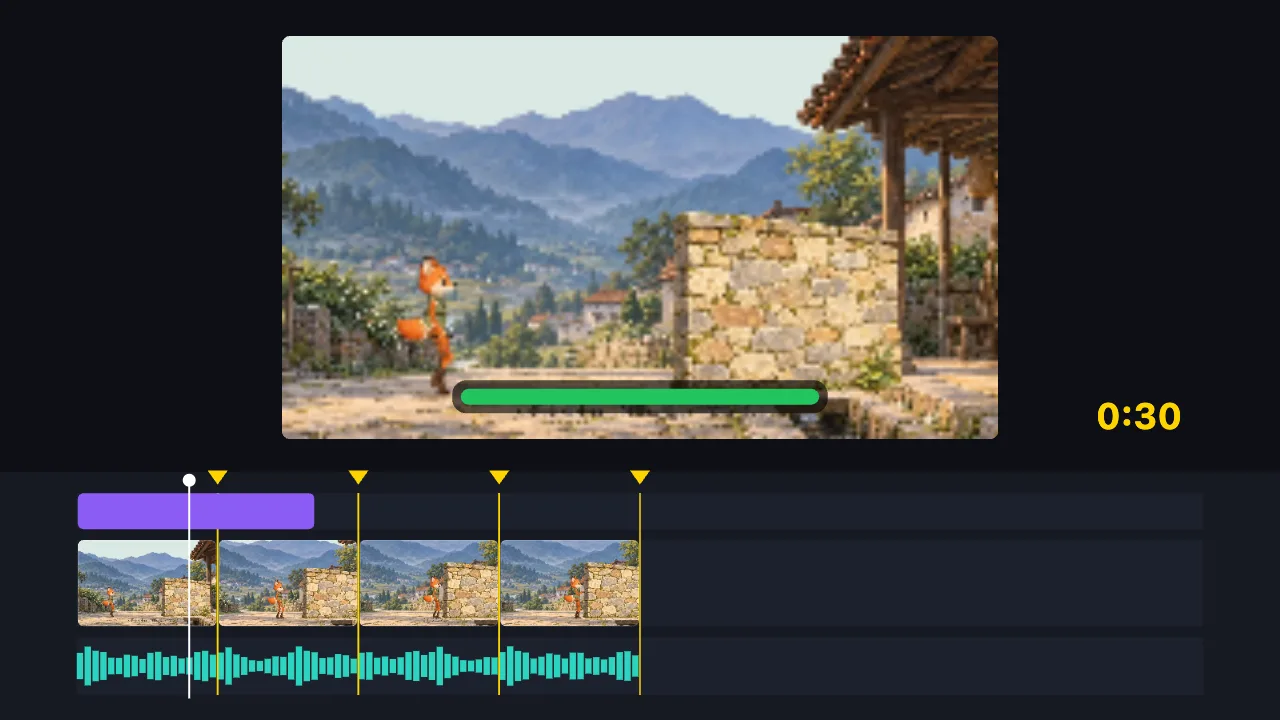
この 2 分の動画を曲のビートで 30 秒に、タイトルも付けて
- 曲のビートを検出
- ビートで 8 分割し、不要部分を削除
- タイトルを追加
- 30 秒の動画を書き出し
あなた:
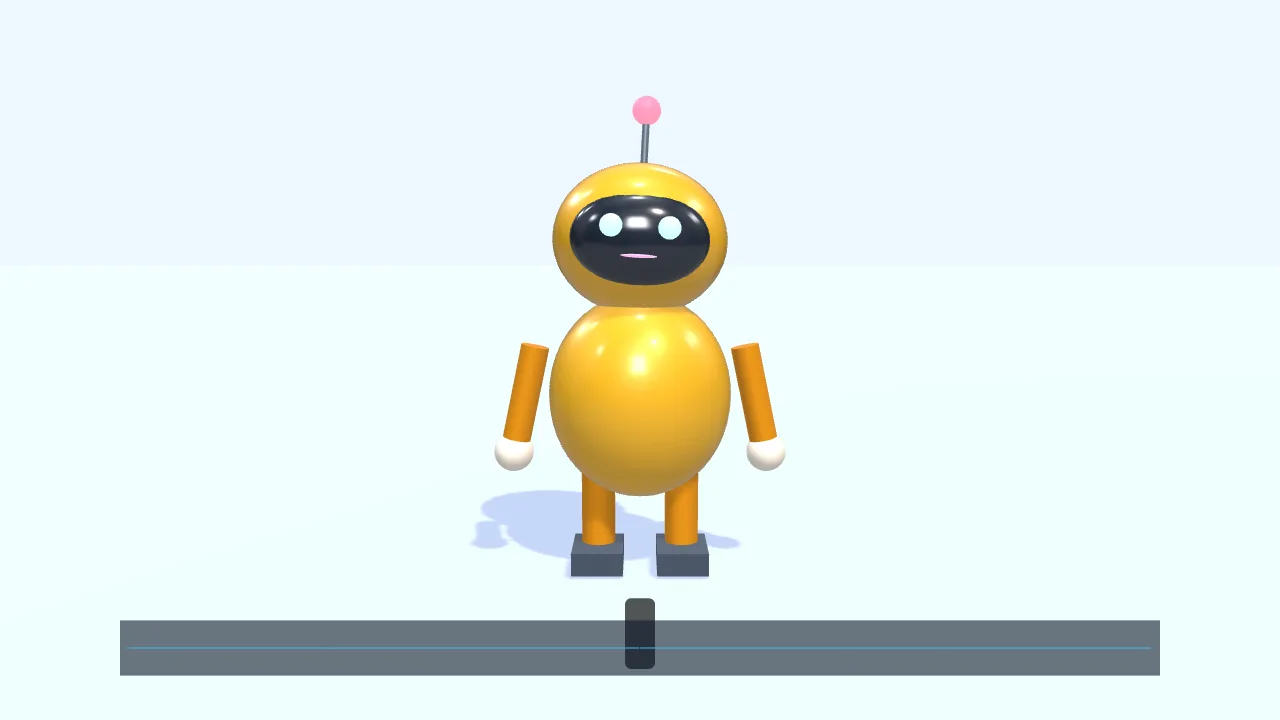
キャラクターを左から歩いて登場させて、この音声に合わせてしゃべらせて
- 3D の小さなロボットを置く
- 画面の中央まで歩いて手を振る
- 音声を入れる
- 声に合わせて口が開閉
- 字幕を付ける
あなた:
金色のギフトボックスを一回転させて、「新発売」と出して
- 3D シーンを作成
- ギフトボックスを置く
- 金色のメタル質感に
- ライトを 2 灯
- 一回転させる
- 「新発売」を表示
あなた:
ギフトボックスの映像に「新発売」のタイトルアニメーションを付けて
- 内蔵のタイトル演出を追加
- タイトルを「新発売」に変更
- 8 秒の動画を書き出し
動画生成モデルも待ち時間もありません。AI がタイムラインを書き、ブラウザがそれを描きます。
AI にできないこと:実写の人物映像の生成 · ぼやけた画質の修復 · 既存の透かしの除去 · 3D モデルファイルをゼロから生成
声を入れる —— 自分で録音するか音声を読み込む —— と、キャラクターの口がその声に合わせて開閉します。無料、ログイン不要。口は音の大きさとリズムに応じていくつかの形を切り替え、処理はブラウザ内で行うので、そのために音声がアップロードされることはありません。追うのは音で、一語一語を正確に合わせるわけではありません。
ただ立っているキャラクターと、しゃべるキャラクターでは、見え方がまるで違います。「キャラクターを左から歩いて登場させて、この音声に合わせてしゃべらせて」と言えば、AI がキャラクターを置き、画面中央まで歩かせ、音声をつなぎ、字幕まで付けます。
まず声を用意します。録音で自分の声を録るか、手持ちの音声を読み込み、それをキャラクターに渡します。口は音の大きさとリズムに合わせて開閉し、いくつかの形を切り替え、音が止まると閉じます。リップシンクの処理はブラウザ内で行うので、そのために音声がアップロードされることはありません。
複数のキャラクターが、それぞれ自分の音声トラックに合わせてしゃべれ、混ざることはありません。はっきりさせておくと、追うのは音の抑揚で、台本の一語一語に合わせるわけではないため、近くで見るとプロのリップシンクアニメのように一音一音は合いません。また、しゃべらせられるのは描かれたキャラクターだけで、写真や動画の実在の人物に「しゃべらせる」ことはしません。
よくある質問
- 口の動きは一語ずつ正確に合いますか?
- 合いません。音の大きさとリズムを追い、いくつかの口の形を切り替えます。遠目には自然ですが、近くで見ると一音一音までは合いません。
- 声はどこから用意しますか?
- 自分で録音するか、手持ちの音声ファイルを読み込んでください。エディター自体にテキスト読み上げ機能はありません。
- 複数人の会話は作れますか?
- 作れます。各キャラクターは自分の音声トラックに合わせてしゃべり、ほかの音声を拾いません。交互にしゃべらせれば会話になります。
- 写真や動画の実在の人物をしゃべらせられますか?
- できません。しゃべらせられるのは描かれたキャラクターだけで、実在の人の顔は扱いません。
- ログインは必要ですか?音声はアップロードされますか?
- ログインは不要です。リップシンクはブラウザ内で計算するので、そのために音声がアップロードされることはありません。